Aperçu
L’analyse conversationnelle en entreprise consiste à traduire des questions en langage simple en requêtes exécutables dans une base de données, afin que les réponses proviennent directement des plateformes de données structurées sans avoir à écrire de code ou construire un tableau de bord au préalable.
Les modèles génératifs ont rendu la résolution de la question simple. L’obstacle opérationnel s’est déplacé vers un endroit moins évident : vérifier la réponse. Sur les schémas d’entreprise complexes, le texte en SQL non fondé échoue en générant des jointures incorrectes, et les benchmarks publiés placent la précision de déploiement entre 50 % et 70 % sur un schéma brut et au-dessus de 90 % lorsque les requêtes sont compilées à travers une couche sémantique gouvernée. La variation entre les déploiements de la même technologie est plus grande que la variation entre les technologies.
Définition de l’analyse conversationnelle
L’analyse conversationnelle est une couche d’interface, pas un moteur de calcul. Les agrégations, filtres et jointures exécutés dans la base de données restent SQL standard ; ce qui change, c’est qui peut les exécuter et à quelle vitesse une réponse arrive. Au lieu de déposer un ticket auprès d’une équipe centrale de données, l’utilisateur exprime une intention en un langage clair et reçoit un résultat vérifié. Cela se situe dans l’adoption plus large de l’IA tout au long du cycle de vie de l’analytique, au moment où un humain exprime ce qu’il veut savoir.
La valeur ne réside pas dans le remplacement des tableaux de bord qui suivent des mesures connues. C’est dans la réponse aux questions ad hoc et en plusieurs étapes que les tableaux de bord n’ont jamais été conçus pour anticiper — une chute soudaine de marge, une exception fournisseur, une comparaison ponctuelle de cohortes — qui, dans la plupart des organisations, est là où vient la file d’attente des analystes.
Deux modalités clés dans l’entreprise
L’IA conversationnelle s’étend aux domaines grand public et technique. En analytique d’entreprise, le déploiement se divise principalement en deux modalités avec des données différentes, des acheteurs différents et des modes de défaillance différents.
Requête de données métier structurées (texte vers SQL)
Accès en langage naturel aux données structurées stockées dans des plateformes, des maisons lacustres et des entrepôts. Les dirigeants d’entreprise posent des questions opérationnelles — fluctuations régionales de revenus, rotation des stocks, variance trimestrielle — et le système les compile en requêtes de base de données. Ce sont ces questions auxquelles l’intelligence économique a toujours répondu. Ce guide aborde cette modalité.
Analyse des interactions clients non structurées
L’analyse des données conversationnelles elles-mêmes — transcriptions de centres de contact, journaux de discussion, e-mails — pour extraire le sentiment, l’intention et les frictions opérationnelles. Elle dépend de la reconnaissance vocale, de la compréhension linguistique et de l’exploration vectorielle de texte plutôt que de la génération de requêtes. Analyser les conversations clients à grande échelle est un sujet important en soi et est traité séparément. Évaluer les deux nécessite des critères architecturaux totalement différents.
Comment fonctionne l’analyse conversationnelle
Convertir une question humaine en une requête de base de données mathématiquement solide prend quatre étapes. La majeure partie de la différence entre les plateformes réside dans la seconde.
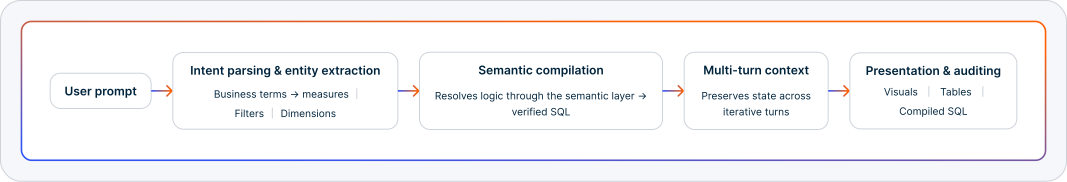
Analyse syntaxique d’intention et extraction d’entités
Les modèles Foundation analysent la demande, isolant des mesures telles que le chiffre d’affaires net, les dimensions comme la région de vente, et les contraintes de temps comme un trimestre par rapport au même trimestre de l’année dernière. La variation linguistique est bien gérée — c’est l’étape dans laquelle les modèles actuels sont compétents.
Génération de requêtes et compilation sémantique
L’intention extraite est compilée en code exécutable. Les systèmes de base génèrent SQL directement sur des noms bruts de colonnes, déduisant comment les tables se connectent. L’architecture avancée est compilée via une couche sémantique gouvernée où les définitions métriques, les chemins de jointure et les règles métier sont certifiés à l’avance. Cette distinction semble technique et constitue le principal facteur déterminant de la justesse de la réponse — la mécanique de l’interrogation des données en langage naturel dépend de cette étape pour éviter la logique hallucinée.
Rétention du contexte sur plusieurs tours
L’analyse réelle est itérative : la deuxième question affine la première, la troisième se rétrécit à nouveau. La rétention du contexte préserve les filtres précédents, les variables d’état et les niveaux d’agrégation, de sorte qu’un suivi ne nécessite pas de tout reformuler — sans cela, les utilisateurs retournent à la file d’attente d’analystes qu’ils essayaient de contourner.
Présentation des résultats et audit des requêtes
Les charges utiles retournées deviennent des graphiques, des tableaux de synthèse ou du texte. De manière cruciale, les plateformes d’entreprise affichent le SQL compilé en même temps que le visuel, afin qu’un analyste puisse auditer la logique exacte qui a produit la sortie. Transformer les résultats en visuels est bien compris ; montrer le travail est ce qui détermine si les analystes lui font confiance.
Pourquoi la précision varie autant
La fiabilité opérationnelle dépend des métadonnées structurelles disponibles au système plutôt que de la capacité brute du modèle qui le sous-tend.
|
Environnement d’évaluation |
Baseline / non mise à la terre |
Gouverné/modélisé |
Sources et détails des tests |
|
Ensemble de données de base non modélisé |
64,5 % au total du texte en SQL |
72,7 % de couche sémantique |
dbt Labs ACME Insurance benchmark, avril 2026 — 11 questions, 20 courses, 15 tableaux |
|
Données entièrement modélisées |
90,0 % (Claude Sonnet 4.6)/84,1 % (Codex GPT-5.3) |
98,2 % (Claude Sonnet 4.6)/100 % (Codex GPT-5.3) |
dbt Labs ACME Insurance benchmark, avril 2026. La qualité de la modélisation améliore à la fois l’exécution directe du SQL et sémantique. |
|
Schémas d’entreprise complexes |
— |
76.13% |
Benchmark BIRD, piste de modèle entraînée unique. Rapporté par le fournisseur. |
Comment la modélisation des données et les couches sémantiques impactent les résultats
Les modèles ne savent pas intrinsèquement comment une organisation définit ses termes. Ils ne peuvent pas déduire un décalage budgétaire personnalisé, une exclusion net-versus-chiffre brut, ou un chemin de jointure correct que personne n’a noté. Une couche sémantique est le tissu de traduction entre la question et le schéma : elle définit chaque métrique une fois, stockant une logique de calcul certifiée, des relations de table et une politique d’accès au niveau des lignes. Le modèle associe l’intention à ces définitions plutôt que de deviner la logique de la base de données. L’ancrage dans le contexte métier garantit que poser la même question rapporte le même nombre à chaque unité métier.
L’implication pour les acheteurs est utile. Si le travail de base sémantique n’a pas été fait, aucun produit de cette catégorie ne performera comme sa démonstration — car la démonstration s’est déroulée sur des données modélisées.
Modes de défaillance à évaluer
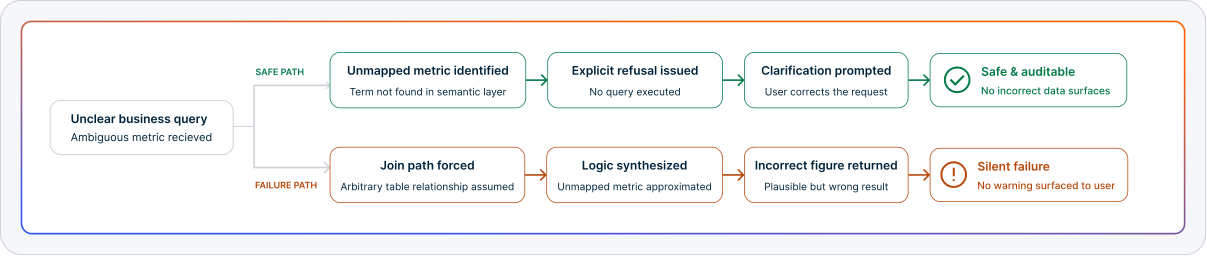
Les moteurs non mis à la terre échouent silencieusement. Ils forcent un chemin de jonction plausible, supposent qu’il manque une valeur de filtre, et renvoient un chiffre confiant et correctement formaté qui est erroné. Personne ne sait comment le vérifier. Dans un board pack, ce chiffre devient une décision. Les praticiens soulèvent ce chiffre de façon constante, et c’est pourquoi les équipes d’analytique expérimentées sont plus prudentes sur cette catégorie que ce que le marketing suggère : la barrière à la posée de questions est tombée, et celle à l’interprétation d’une réponse ne l’a pas fait.
Cas d’usage réels en entreprise
Reporting de cadres et d’affaires en libre-service
Les leaders effectuent une croissance période sur période ou des changements de marges régionales sans rejoindre une file d’attente d’analystes.
Exigence de mise en œuvre : Définitions centralisées des métriques, donc deux cadres posant la même question reçoivent le même chiffre.
Décomposition par variance financière
La finance examine la variance des lignes pendant la clôture, isolant si un dépassement provient du volume, du prix ou de la devise.
Exigence d’implémentation : Hiérarchies de comptes certifiés et drapeaux de fermeture de période conservés dans la couche de métadonnées.
Surveillance des opérations et des exceptions de la chaîne d’approvisionnement
La logistique retrace les goulots d’étranglement à travers les réseaux de fournisseurs multi-régions et identifie les stocks affectés dès qu’une exception se déclenche.
Exigence de mise en œuvre : Traitement des requêtes à forte concurrence et données opérationnelles actuelles.
Cohorte client et analyse marketing
Le marketing dimensionne les cohortes et mesure la valeur à vie à travers des attributs personnalisés sans support technique dédié.
Exigence de mise en œuvre : Résolution fiable des identités à travers les tables CRM et de facturation.
Avantages et dépendances de gouvernance
La latence des décisions diminue parce que la boucle de plusieurs jours via une file de signalement disparaît. Les ingénieurs de données sont libérés du travail de récupération pour se concentrer sur la modélisation et la gouvernance de la plateforme. Plus de décisions sont prises sur la base des preuves plutôt que sur l’instinct, qui est le résultat que l’intelligence décisionnelle poursuit depuis des années.
Chaque avantage comporte la même dépendance. Les interfaces en langage naturel facilitent la pose ; la gestion sémantique centralisée est ce qui rend les réponses fiables. La valeur n’arrive que lorsque le sens commercial a été capturé dans la couche de données plutôt que dans la tête des personnes qui répondaient auparavant aux questions.
Que faire évaluer dans un logiciel d’analyse conversationnelle d’entreprise
Les démonstrations dans cette catégorie sont exceptionnellement convaincantes car elles s’articulent avec des données modélisées pour la démonstration. Sept questions séparent ce qu’un produit montre de ce qu’il fera sur un environnement d’entreprise.
|
Exigence |
Test de résistance à poser dans la démo |
Pourquoi il décide de l’issue |
|
Gouvernance métrique centralisée |
Où se situent les définitions métriques — dans des modèles de prompts ou dans une couche sémantique ? |
Les définitions au niveau de la consigne provoquent des dérives métriques entre unités métier. La logique doit être centralisée. |
|
Gestion déterministe des pannes |
Que se passe-t-il lorsqu’une requête nomme une métrique non cartographiée ? |
Le système doit refuser ou clarifier. Une hallucination silencieuse à l’intérieur d’un rapport financier est un risque non surveillé. |
|
Auditabilité SQL |
Un analyste peut-il voir, déboguer et copier le SQL généré ? |
Les analystes ne feront pas confiance aux résultats qu’ils ne peuvent pas inspecter, et les rapports réglementés ne peuvent pas les utiliser. |
|
Droits au niveau de la base de données |
La requête s'exécute-t-elle sous le rôle de base de données de l'utilisateur ou sous un compte de service ? |
Si l’interface contourne le modèle d’accès, elle crée un problème de gouvernance, et n’a pas résolu un problème d’accès. |
|
Exécution fédérée |
Le moteur peut-il interroger entre des ensembles hybrides et multi-cloud sans déplacer les données ? |
La plupart des plateformes de cette catégorie interrogent un seul entrepôt. Tout le reste nécessite une fédération ou une réplication. |
|
Accès aux données non structurées |
Peut-il relier des tables relationnelles avec des transcriptions et des journaux intégrés en vecteurs ? |
Une part croissante de questions d’entreprise touche à des contenus qui ne figurent jamais dans un tableau. |
|
Plan de contrôle unifié |
Les modèles, les définitions sémantiques et la télémétrie sont-ils gérés ensemble ? |
Les plateformes qui gèrent tout cela ensemble — comme Teradata AI Studio — répondent à plusieurs de ces questions à partir d’un seul endroit. |
Où cela va-t-il aller : analytique agente et protocoles ouverts
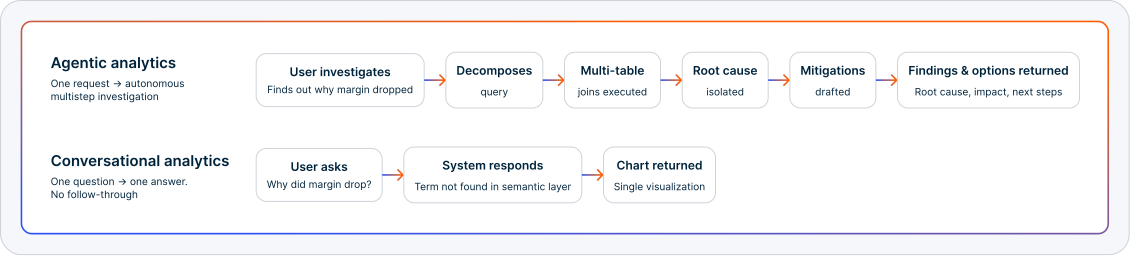
L’analyse conversationnelle répond à une demande. L’IA agente accomplit une tâche : planifier une séquence, lancer plusieurs requêtes, évaluer les résultats et décider de la suite. Appliqué à l’analytique, cela signifie un système qui enquête plutôt que ne répond. Les agents IA en intelligence économique sont la forme à court terme de cela.
L’autonomie modifie ce que l’intégration doit offrir. Des interfaces ouvertes telles que le protocole Model Context standardisent la communication entre agents et outils externes ; des implémentations d’entreprise telles que Teradata Enterprise MCP ajoutent authentification, autorisation et contrôle d’accès basé sur les rôles. Des couches d’orchestration telles que Teradata Enterprise AgentStack fournissent les limites de télémétrie et de sécurité qui rendent le déploiement contre des données de production défendable, et les systèmes multi-agents affinent encore davantage ce point — l’attribution devient vraiment difficile lorsque plusieurs agents contribuent à un seul résultat.
Conclusion
L'analyse conversationnelle modifie la manière dont les équipes d'entreprise accèdent à leurs données, mais le succès dépend bien plus de la base sémantique que de la conception de l'interface. Le fait que cela fonctionne dans chaque organisation dépend des données de cette organisation : si les métriques sont définies une seule fois, si les permissions sont valables là où les données sont atteintes, et si le système le dit quand il ne le sait pas. Les plateformes qui ancrent les requêtes en langage naturel dans une logique métier certifiée — comme Tera fonctionnant sur Teradata Cloud — arrivent à la même conclusion que les benchmarks : l'interface est la partie facile, et le sens sous-jacent ne l'est pas.
Pour évaluer l’analyse conversationnelle gouvernée selon vos propres définitions de métriques et votre modèle d’accès plutôt qu’un jeu de données de démonstration, contactez-nous.
Questions fréquemment posées
Quelle est la différence entre l’analyse conversationnelle et l’IA conversationnelle ?
Quelle est la différence entre l’analyse conversationnelle et l’IA conversationnelle ?
L’IA conversationnelle est le vaste champ des systèmes qui tiennent un dialogue — assistants virtuels, bots de centre de contact. L’analyse conversationnelle est l’application plus restreinte de cette capacité aux données : les questions concernent des métriques, des tendances et des segments, et la réponse est produite en interrogeant une source de données plutôt qu’en récupérant une réponse scriptée.
L’analyse conversationnelle remplace-t-elle les tableaux de bord ?
L’analyse conversationnelle remplace-t-elle les tableaux de bord ?
Non. Les tableaux de bord restent le moyen le plus efficace de surveiller un ensemble fixe de mesures que beaucoup de personnes observent. L’analyse conversationnelle les complète en gérant les questions ponctuelles et en plusieurs étapes qu’un tableau de bord n’a jamais été conçu pour anticiper.
Les utilisateurs doivent-ils toujours comprendre les données ?
Les utilisateurs doivent-ils toujours comprendre les données ?
Oui, et c’est la mauvaise lecture la plus courante de cette catégorie. Ces outils abaissent la barrière à poser une question sans abaisser celle à l’interprétation de la réponse. Quelqu’un doit toujours savoir si le chiffre signifie ce qu’il semble signifier, c’est pourquoi le contexte métier dans la couche de données compte plus que la finition conversationnelle de l’interface.
En quoi l’analyse conversationnelle diffère-t-elle de l’analytique agente ?
En quoi l’analyse conversationnelle diffère-t-elle de l’analytique agente ?
L’analyse conversationnelle répond à une question. L’analytique agente accomplit une tâche : elle planifie une séquence d’étapes, lance plusieurs requêtes, évalue ce qui revient et décide de la suite. La distinction se situe entre un système qui répond et un autre qui agit, et elle modifie la gouvernance dont le déploiement a besoin.