Teradata fait évoluer Tera en « collaborateur agentique », avec le lancement de Tera Context Engine et Tera Harness
22 sept. 2026 | SAN DIEGO | PARIS
Conçu pour les environnements de données d’entreprise, Tera met à la portée de chaque rôle data des connaissances métier gouvernées et une exécution intelligente, pour accélérer les processus, réduire les coûts et gagner en efficacité.
Teradata (NYSE: TDC) annonce aujourd’hui une évolution majeure de Tera, qui devient un véritable « collègue agentique » conçu pour les environnements de données d’entreprise. Là où les assistants IA généralistes se limitent souvent à générer des réponses, Tera va plus loin en produisant des résultats tangibles. Grâce au langage naturel et à une exécution guidée, Tera permet à tous les profils data — des analystes métier aux ingénieurs de plateformes et aux administrateurs de bases de données — d’analyser les données, de développer des applications d’IA, de gérer les infrastructures et d’automatiser des workflows complexes, le tout depuis un environnement unique et gouverné. Tera peut accéder aux données d’entreprise réparties sur l’ensemble des plateformes, et pas uniquement au sein de Teradata. L’expertise sectorielle et les connaissances métier sont intégrées à chaque interaction et protégées par les mécanismes d’identité et les politiques de l’entreprise, permettant aux utilisateurs de bénéficier de ces capacités sans nécessiter une expertise approfondie de Teradata.
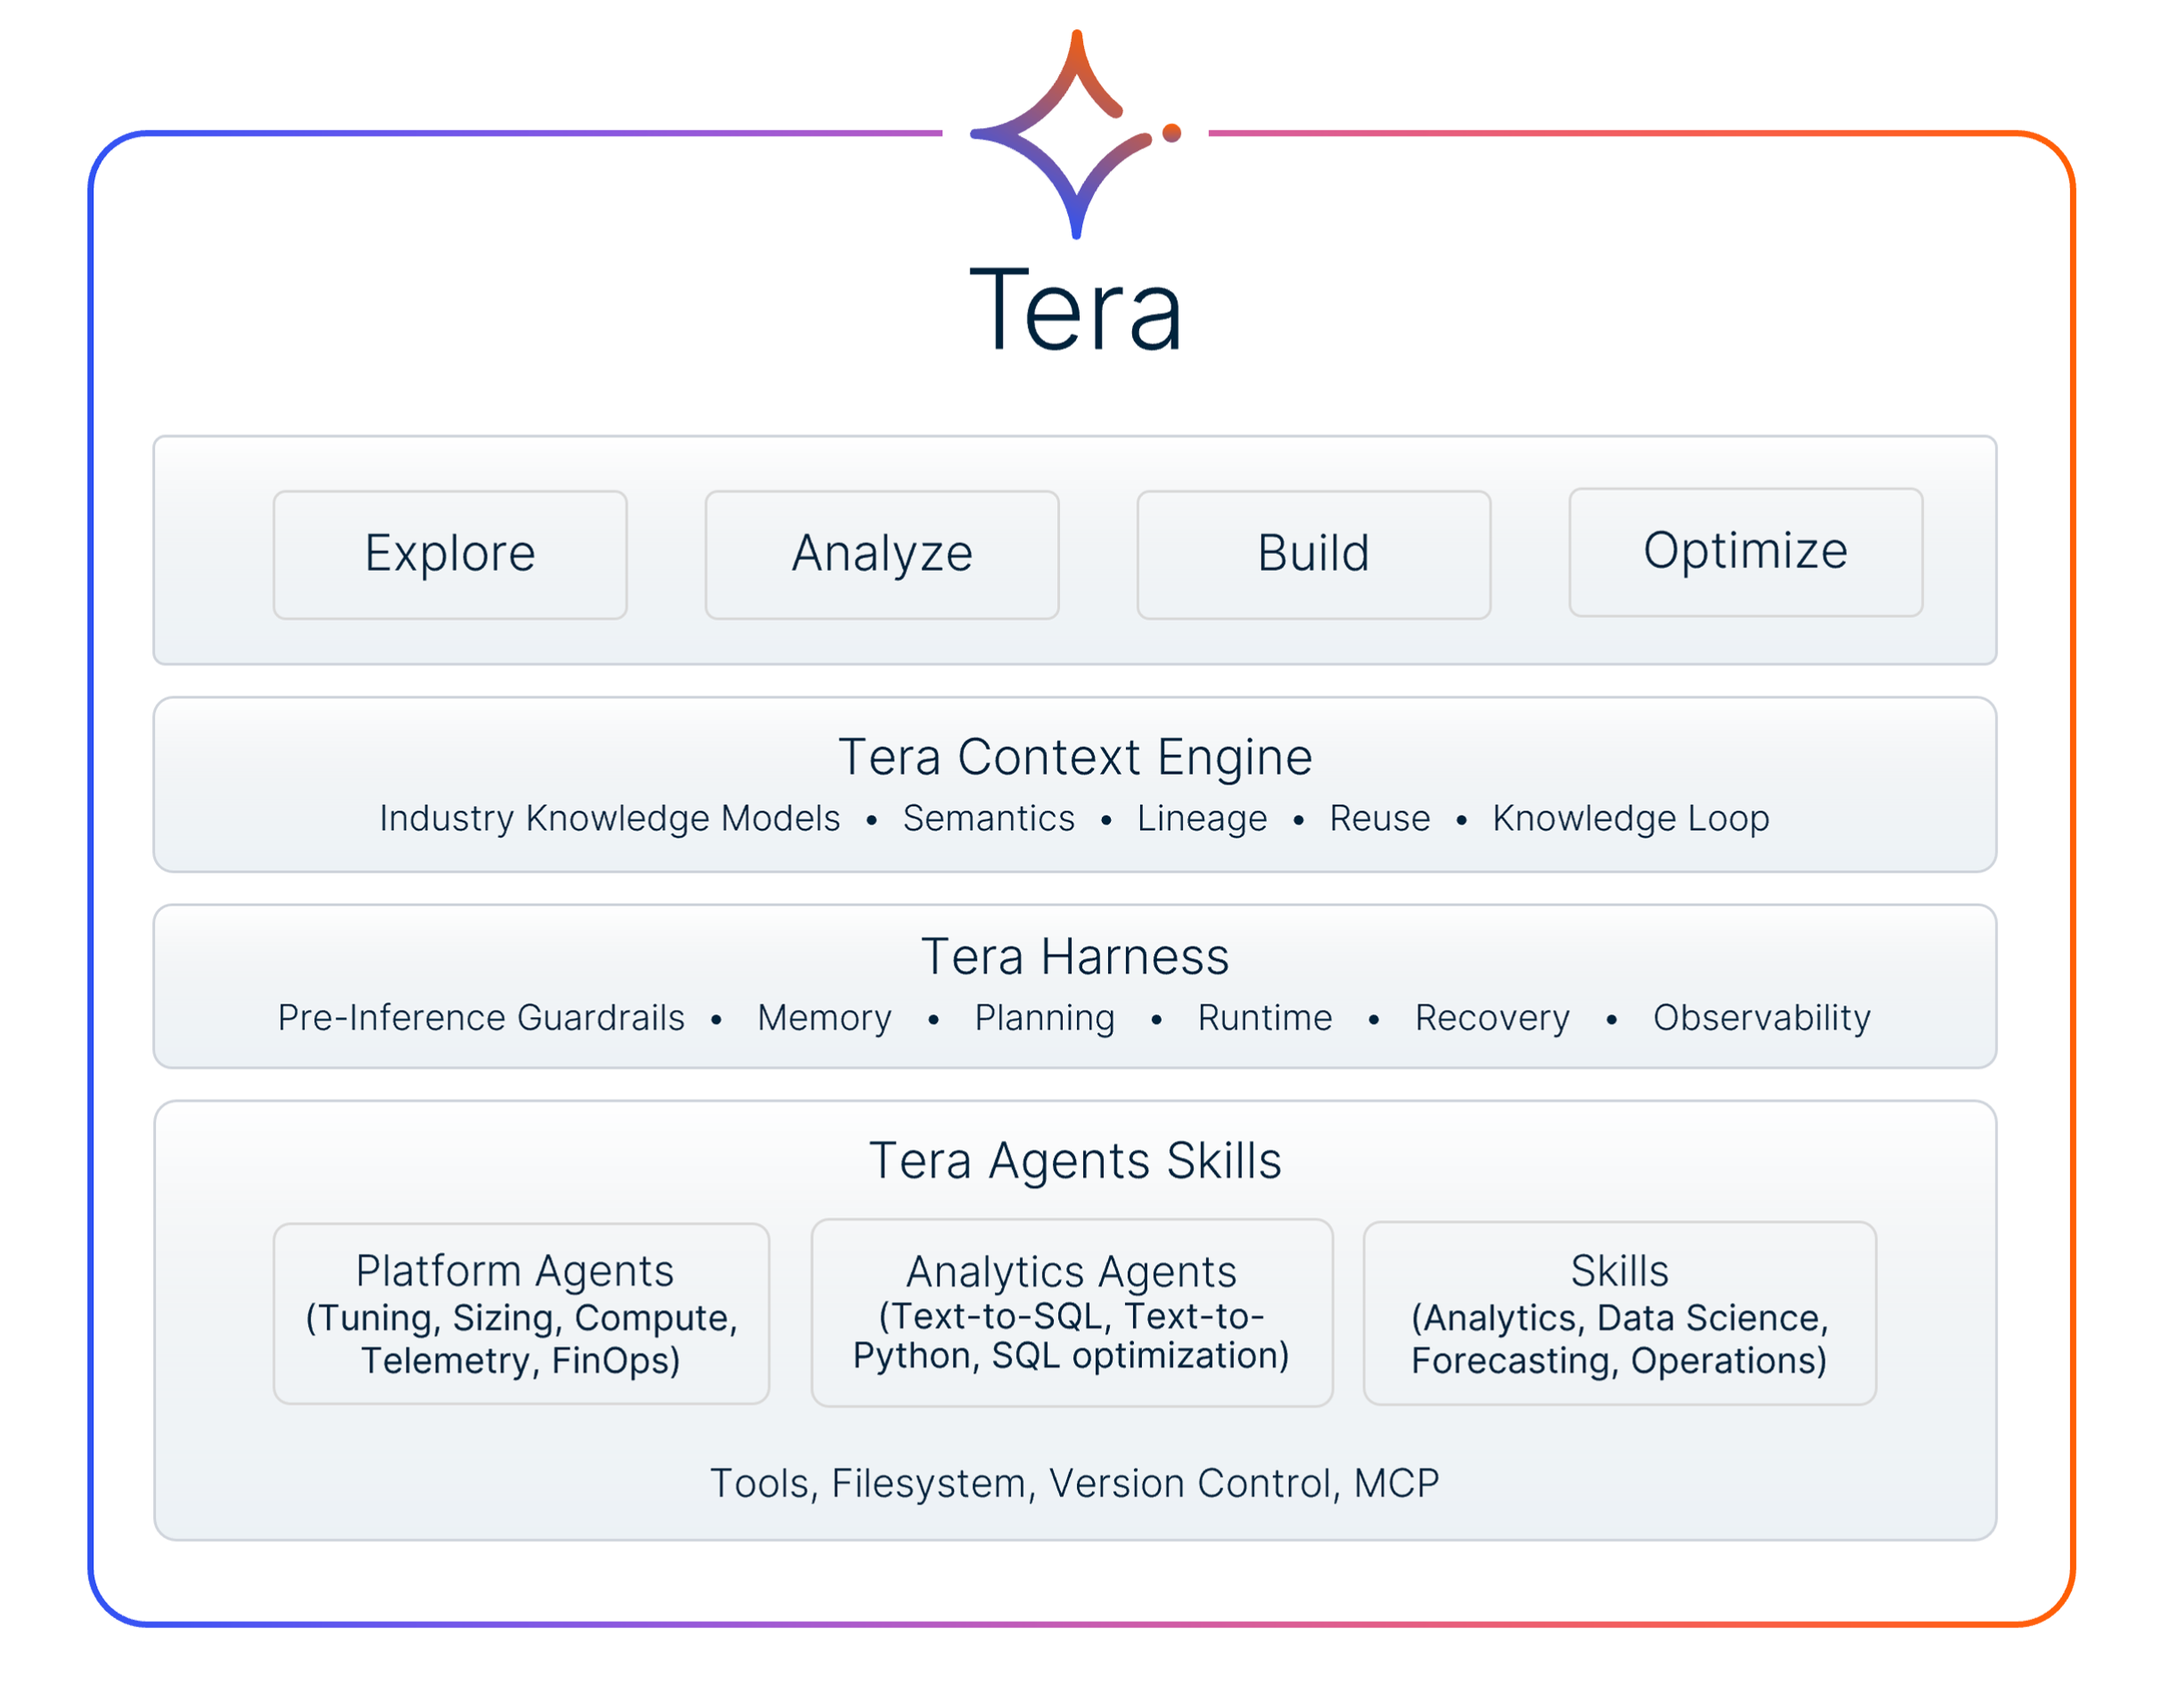
Tera s’appuie sur trois fonctionnalités clés :
*NOUVEAU* Tera Context Engine, une couche de contexte et d’orchestration indépendante des éditeurs, qui fournit à l’IA les connaissances métier nécessaires pour comprendre le contexte de l’entreprise ;
*NOUVEAU* Tera Harness, une couche d’exécution intelligente qui oriente chaque tâche vers les compétences, les outils, les données et les modèles les plus adaptés ;
*NOUVEAU* Agent Skills, un ensemble de compétences spécialement conçues pour l’ingénierie, l’analyse et la science des données.
Tera répond ainsi à deux enjeux majeurs auxquels l’IA d’entreprise se heurtait jusqu’à présent : comprendre le contexte métier et agir à partir de cette compréhension. Les clients de Teradata peuvent ainsi obtenir des résultats d’IA plus fiables, améliorer la rentabilité de chaque interaction avec les modèles et accélérer le retour sur investissement. Pour les organisations qui souhaitent aller plus vite dans leur déploiement, Teradata AI Services complètent ces capacités en apportant l’expertise et l’accompagnement nécessaires.
Résultats des tests de performance
Tera a été conçu spécifiquement pour les environnements de données d’entreprise, afin d’optimiser l’exécution des analyses, des traitements vectoriels et des modèles. Lors de tests réalisés sur SWE-bench Pro avec le même modèle, Opus 5, Tera a consommé 73 % de jetons (tokens) en moins que Claude Code, tout en affichant des taux d’achèvement des tâches plus élevés, en exécutant les tâches 42 % plus rapidement et avec un coût total inférieur de 58 %. Sur data-eng-bench, un benchmark développé par Snowflake Labs et Bespoke Labs pour évaluer les capacités d’ingénierie des pipelines de données, Tera a affiché un coût par tâche résolue de manière fiable inférieur de 53 % à celui de Snowflake Cortex Code avec Opus 5, selon les données de benchmark publiées par Snowflake et Bespoke Labs. Sur les benchmarks data-eng-bench et ADE-bench, Tera a également obtenu des résultats parmi les plus élevés, avec le score Pass3 le plus élevé sur data-eng-bench et un classement ex æquo en tête sur ADE-bench. La méthodologie complète des tests de performance ainsi que les résultats détaillés, y compris les documents permettant une validation indépendante, sont disponibles ici.
Citation d’un dirigeant Teradata
Présentation et composants de Tera
Tera fait partie de la Teradata Autonomous Knowledge Platform et s’articule autour de trois fonctionnalités spécialement conçues pour fonctionner ensemble ou indépendamment : Tera Context Engine, dédié à la gestion des connaissances d’entreprise ; Tera Harness, consacré à l’exécution intelligente ; et Tera Agents, qui apporte une expertise spécialisée. Ensemble, ces composants font de Tera un véritable « collègue agentique », capable de comprendre le contexte métier, de mobiliser les capacités les plus pertinentes et de contribuer à l’exécution des opérations sur les données jusqu’à l’obtention d’un résultat concret. Les entreprises conservent par ailleurs le contrôle de leur environnement : elles peuvent choisir les modèles qu’elles utilisent, l’emplacement d’exécution de leurs workloads et les modalités d’accès à leurs données, qu’elles soient hébergées dans le cloud, on-premises ou dans des environnements souverains.
Tera exécute également l’IA nativement au sein de l’environnement Teradata, notamment depuis la console Teradata destinée aux administrateurs de bases de données. Les workloads analytiques et de machine learning peuvent ainsi être exécutées directement sur les données d’entreprise, sans nécessiter le recours à des modèles externes. Cette approche limite les transferts de données et la latence, tout en réduisant le risque d’« hallucinations » pour les tâches quantitatives telles que les prévisions, la régression ou la segmentation.
*NOUVEAU* Tera Context Engine
Tera Context Engine est une couche ouverte et indépendante de contexte et d’orchestration, conçue pour fonctionner au-dessus des environnements de données que les entreprises utilisent déjà et à travers ceux-ci. Elle connecte bases de données, plateformes de données structurées et non structurées, moteurs de pipelines, catalogues, modèles et agents d’IA, sans déplacer les données, remplacer les technologies existantes ni imposer de dépendance à un fournisseur unique. Surtout, Tera Context Engine ne se limite pas aux données gérées par Teradata : il offre aux organisations une base cohérente de connaissances fiables, quel que soit l’endroit où leurs données sont hébergées.
Graphe de contexte natif : Tera Context Engine transforme des données d’entreprise dispersées en connaissances métier réutilisables en reliant métadonnées, traçabilité, sémantique et signification métier sous forme de relations, plutôt que de les réduire à des structures relationnelles. Contrairement à l’utilisation isolée de catalogues ou d’ontologies, ces connaissances restent associées aux mécanismes de gouvernance, à la traçabilité et aux contrôles d’accès lorsqu’elles circulent entre les systèmes et les agents. Tera Context Engine peut également lire les systèmes de référence existants et y réécrire des données, tout en apprenant de leur utilisation réelle au sein de l’entreprise et en s’enrichissant au fil du temps. Cette approche réduit considérablement les efforts de maintenance manuelle et permet de disposer d’un contexte plus complet et explicable, avec une provenance des résultats d’IA compréhensible et vérifiable par les organisations.
Modèles neurosymboliques : Tera Context Engine associe une cartographie sémantique autonome et une recherche déterministe aux Industry Knowledge Models, issus de l’expertise validée par les experts de Teradata et de sa collaboration avec certaines des entreprises les plus complexes au monde. Plutôt que de demander aux agents de reconstruire le contexte métier à partir de zéro, ces modèles fournissent une base de connaissances symbolique qui associe connaissances explicites de l’entreprise et IA statistique. Ils intègrent notamment la terminologie, les relations, les politiques et les conditions opérationnelles propres à chaque secteur. Les entreprises peuvent ainsi réduire les erreurs des agents et accélérer le retour sur investissement de leurs initiatives d’IA.
Économie des requêtes déterministes : Grâce à un contexte sémantique gouverné et à une recherche déterministe, Tera Context Engine fait évoluer les traitements d’un raisonnement probabiliste coûteux vers des chemins d’exécution gouvernés. Les modèles ont ainsi moins besoin de multiplier les appels pour retrouver ou interpréter des définitions déjà établies. Cette approche contribue à améliorer la précision, à réduire les coûts d’inférence et à rendre les dépenses plus prévisibles à mesure que les workloads agentiques se développent. Dans les secteurs réglementés, les résultats de l’IA restent vérifiables et traçables jusqu’aux données sources, tandis que les règles de gouvernance, les politiques d’accès et les contrôles de conformité sont préservés lorsque les connaissances circulent entre les systèmes.
Automatisation agentique gouvernée : Au-delà de la mise à disposition du contexte nécessaire à l’IA, Tera Context Engine permet aux agents d’agir dans un environnement gouverné. Il automatise notamment la création de produits de données, la définition des spécifications de pipelines et les contrôles de validation, tout en appliquant de manière cohérente les définitions et les politiques de l’entreprise. Les organisations peuvent ainsi mettre plus rapidement à disposition des produits de données fiables, tout en réduisant les efforts manuels consacrés à leur préparation et à leur gouvernance, à l’échelle de l’entreprise.
*NOUVEAU* Tera Harness
Contrairement aux agents généralistes qui se contentent de générer des réponses et laissent aux utilisateurs le soin d’en tirer les conséquences, Tera Harness transforme les intentions en résultats concrets. Il préserve le contexte tout au long des workflows et coordonne automatiquement, à chaque étape, les compétences, les outils, les données et les modèles les plus adaptés, sans nécessiter d’orchestration manuelle.
Boucle d’exécution optimisée pour les coûts : Tera Harness réduit les itérations inutiles avant qu’elles ne génèrent des coûts, notamment en regroupant les tâches indépendantes, en éliminant les interactions entre modèles et outils qui n’apportent pas de valeur au résultat et en adaptant l’exécution à l’avancement des tâches. Plutôt que de solliciter à nouveau de grands modèles de langage (LLM) pour déterminer la marche à suivre à chaque étape, Tera applique 84 modèles d’exécution éprouvés avant l’inférence, afin que les agents disposent dès le départ d’un plan d’exécution. Cette approche permet de mener à bien des workflows complexes en plusieurs étapes de manière maîtrisée, sans multiplier les itérations imprévisibles entre les modèles.
Des garde-fous intégrés à l’exécution : Avant même le lancement d’une tâche, Tera Harness applique des contrôles de pré-inférence, charge le contexte pertinent et planifie l’exécution. Les mécanismes de sécurité, les politiques de gouvernance et les validations humaines sont directement intégrés à la boucle agentique, afin de bloquer les actions à risque avant leur exécution. Plutôt que de s’appuyer uniquement sur l’autorégulation des agents ou sur des filtres externes, Tera applique la gouvernance au niveau même de l’exécution, renforçant ainsi la protection contre les actions non autorisées ou potentiellement destructrices.
Un moteur de performance Go-Native : Tera Harness s’appuie sur un moteur Go-Native et gRPC, conçu pour permettre l’exécution de nombreux agents en parallèle et des communications à faible latence. Alors que certains frameworks agentiques exécutent chaque agent comme un processus distinct, ce qui peut accroître les coûts d’infrastructure et la latence à grande échelle, Tera a permis d’exécuter 512 agents simultanément sur une seule machine virtuelle dotée de 8 vCPU, avec un débit de 279 appels d’outils par minute. Les entreprises peuvent ainsi faire évoluer leurs workloads agentiques sans subir une augmentation proportionnelle des coûts d’infrastructure et de la latence.
Une exécution agentique durable : Pendant l’exécution, Tera Harness surveille la progression des tâches, récupère après les défaillances plutôt que de les abandonner et fournit une visibilité complète sur la manière dont le travail a été réalisé. La gestion de l’état et les points de contrôle sont intégrés directement à la couche d’exécution : les agents peuvent ainsi fonctionner pendant plusieurs jours ou semaines, être mis en pause pour attendre une validation humaine sans mobiliser de ressources de calcul, puis reprendre exactement là où ils s’étaient arrêtés après une défaillance de l’infrastructure. Cette approche évite de dépendre d’une couche d’orchestration distincte pour gérer la résilience des workflows tout en maintenant des ressources cloud actives pendant les périodes d’attente.
Pour les entreprises qui déploient l’IA à grande échelle, cette approche peut se traduire par moins d’appels aux modèles pour chaque résultat, une réduction des coûts liés aux tokens, une meilleure précision et une exécution plus rapide.
*NOUVEAU* Agent Skills
Les compétences des agents sont des capacités réutilisables, conçues pour des tâches spécifiques, qui transforment des décennies d’expertise Teradata en fonctionnalités directement accessibles par l’IA. Elles peuvent être invoquées par n’importe quel agent ou harnais et sont également accessibles directement en langage naturel. Les utilisateurs peuvent ainsi réaliser des opérations avancées sur les données et la plateforme sans nécessiter une expertise technique approfondie. Plutôt que de demander aux modèles de raisonner à partir de zéro, les compétences fournissent des instructions structurées pour les tâches courantes liées aux données et à la plateforme. Elles contribuent ainsi à améliorer la cohérence des résultats et à réduire le risque d’erreurs ou de détours inutiles. Les compétences pertinentes sont chargées automatiquement en fonction de la tâche à accomplir, tandis que Tera achemine chacune d’elles vers les modèles et les outils les plus adaptés. Grâce à la connectivité MCP (Model Context Protocol), les organisations peuvent également enrichir Tera avec leurs propres outils et intégrations.
Tera intègre deux catégories d’agents spécialement conçus qui s’appuient sur ces compétences. Les agents de plateforme prennent en charge les tâches opérationnelles liées à l’environnement Teradata, notamment l’optimisation des workloads, le dimensionnement des ressources de calcul, la télémétrie et les opérations de FinOps. Les agents d’analyse, quant à eux, prennent directement en charge les tâches liées aux données, depuis les requêtes en langage naturel jusqu’à la génération et l’utilisation de SQL et Python, en passant par l’optimisation des requêtes.
En combinant ces compétences réutilisables avec des agents spécialisés, Tera permet ainsi d’automatiser des opérations complexes tout en rendant les capacités avancées de la plateforme accessibles à un plus grand nombre d’utilisateurs.
Teradata AI Services
Pour les organisations qui souhaitent accélérer leur déploiement, les services d’IA Teradata les accompagnent au-delà de la phase d’expérimentation afin de transformer plus rapidement leurs initiatives d’IA en résultats concrets et opérationnels. Ces services permettent d’identifier les cas d’usage pour lesquels un contexte gouverné peut générer une valeur mesurable, de configurer des modèles de connaissances sectoriels et de mettre plus rapidement en production les connaissances de l’entreprise grâce aux technologies Tera. La méthodologie AI Value Engineering de Teradata vise à concevoir et développer les programmes d’IA dès le départ dans une logique de mise en production, plutôt que de les limiter à des projets expérimentaux. Des agents et des outils préconfigurés, conçus pour accompagner chaque étape du cycle de développement de l’IA, contribuent également à accélérer la création de valeur pour les clients.
Disponibilité
Tera Context Engine, Tera Harness et Agent Skills seront disponibles au quatrième trimestre 2026.
Déclarations prospectives
Le présent communiqué de presse contient des « déclarations prospectives » au sens de la législation applicable, qui portent notamment sur les attentes, convictions, projets et intentions de Teradata concernant Tera, notamment Tera Context Engine, Tera Harness et Agent Skills. Ces déclarations concernent entre autres la disponibilité future des produits, leurs fonctionnalités et les offres associées, ainsi que les avantages que ces solutions pourraient apporter aux clients de Teradata. Les déclarations prospectives reposent sur des hypothèses et sont soumises à des risques et incertitudes, connus ou inconnus, qui pourraient entraîner des résultats réels sensiblement différents de ceux exprimés ou sous-entendus dans ces déclarations. Si l’un de ces risques ou incertitudes venait à se concrétiser, ou si l’une des hypothèses sous-jacentes s’avérait incorrecte, les résultats de Teradata pourraient différer sensiblement de ceux anticipés ou présentés dans les déclarations prospectives. Teradata n’assume aucune obligation de mettre à jour ces déclarations prospectives et n’a pas l’intention de le faire. Parmi les facteurs susceptibles d’entraîner un écart significatif entre les résultats réels et ceux exprimés ou sous-entendus dans ces déclarations figurent notamment les retards, difficultés ou dépenses imprévues liés au développement et au déploiement des fonctionnalités et offres de produits prévues, l’évolution du cadre réglementaire applicable à l’IA, ainsi que l’incertitude concernant l’adoption de ces solutions par les clients et la capacité de cette adoption à justifier les investissements réalisés dans leur développement. Des informations complémentaires sur les facteurs susceptibles d’avoir une incidence sur les résultats financiers et autres de Teradata figurent dans les documents que Teradata dépose périodiquement auprès de la Securities and Exchange Commission (SEC).
À propos de Teradata
Teradata permet aux entreprises de transformer l’intelligence en actions autonomes, en intégrant les agents IA à un contexte métier riche et à des données fiables. À mesure que l’adoption des agents IA s’accélère, Teradata fournit la base contextuelle, la couche de gouvernance et l’infrastructure de performance essentielles aux organisations. La plateforme Teradata Autonomous Knowledge facilite la mise en production de l’IA dans des environnements cloud, on-premises et hybrides, en assurant cohérence, contrôle et performance.